Cómo saber si una serie es estacionaria: la ACF que no baja y el test de Dickey-Fuller, con ejemplos en R
Abres el correlograma de tu serie y ves una ACF que empieza en casi 1 y no termina de bajar. No has encontrado un modelo: has encontrado una serie no estacionaria, y así no se puede identificar nada. Antes de buscar el AR o el MA hay que resolver esto.
Aquí vamos a ver por qué pasa, cómo confirmarlo con Dickey-Fuller y cuántas veces hay que diferenciar: ni una de menos ni una de más.
Si prefieres verlo paso a paso en pantalla, está en vídeo: No estacionariedad en R: la ACF que no baja y Dickey-Fuller.
La regla, por adelantado
| Lo que ves | Qué significa | Qué hacer |
|---|---|---|
| La ACF empieza cerca de 1 y no baja | Raíz unitaria | Diferenciar y confirmar con Dickey-Fuller |
| Tras diferenciar, la ACF cae rápido | Una diferencia basta | Identificar el modelo |
| cerca de −0.5 | Te has pasado | Quitar una diferencia |
Por qué la ACF no baja: el paseo aleatorio
El caso extremo es el paseo aleatorio: hoy es ayer más un shock.
Los shocks se acumulan, así que la varianza crece con el tiempo, y la correlación entre hoy y dentro de periodos es prácticamente 1:
Por eso la ACF no baja: el pasado no se olvida nunca.
Un caso real: los precios al por mayor de Estados Unidos
Usamos el índice de precios al por mayor de Estados Unidos, trimestral, de 1960 a 1990, de Stata Press. Lo leemos con read_dta, de haven, y lo pasamos a tsibble con el logaritmo y sus diferencias.
library(haven)
library(dplyr)
library(tsibble)
library(urca)

wpi <- read_dta("https://www.stata-press.com/data/r17/wpi1.dta") |>
  mutate(trimestre = yearquarter("1960 Q1") + row_number() - 1) |>
  select(trimestre, wpi, ln_wpi) |>
  as_tsibble(index = trimestre) |>
  mutate(d = difference(ln_wpi), d2 = difference(ln_wpi, differences = 2))
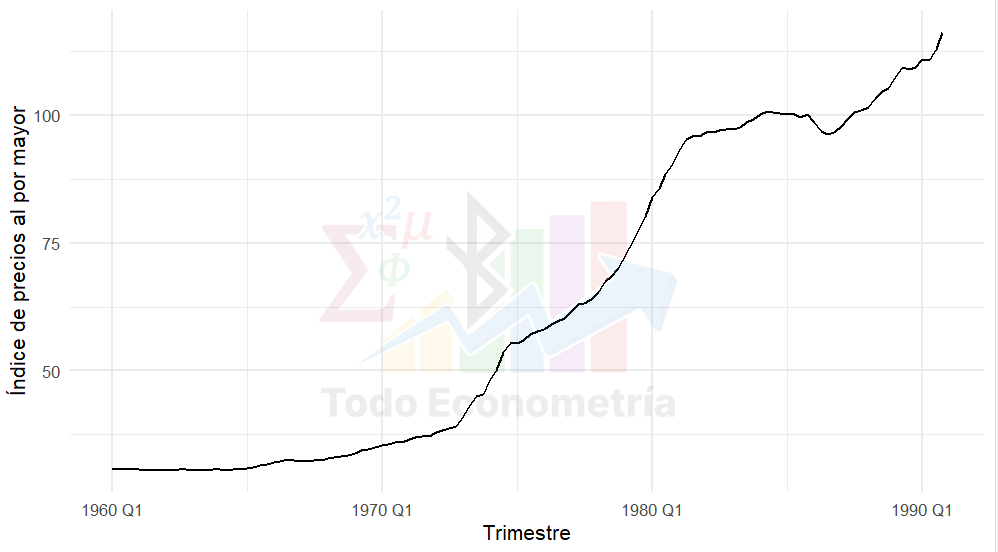
La serie sube de 30 a casi 120 en treinta años, con el salto de los setenta. No vuelve a ningún nivel: la media no es constante.
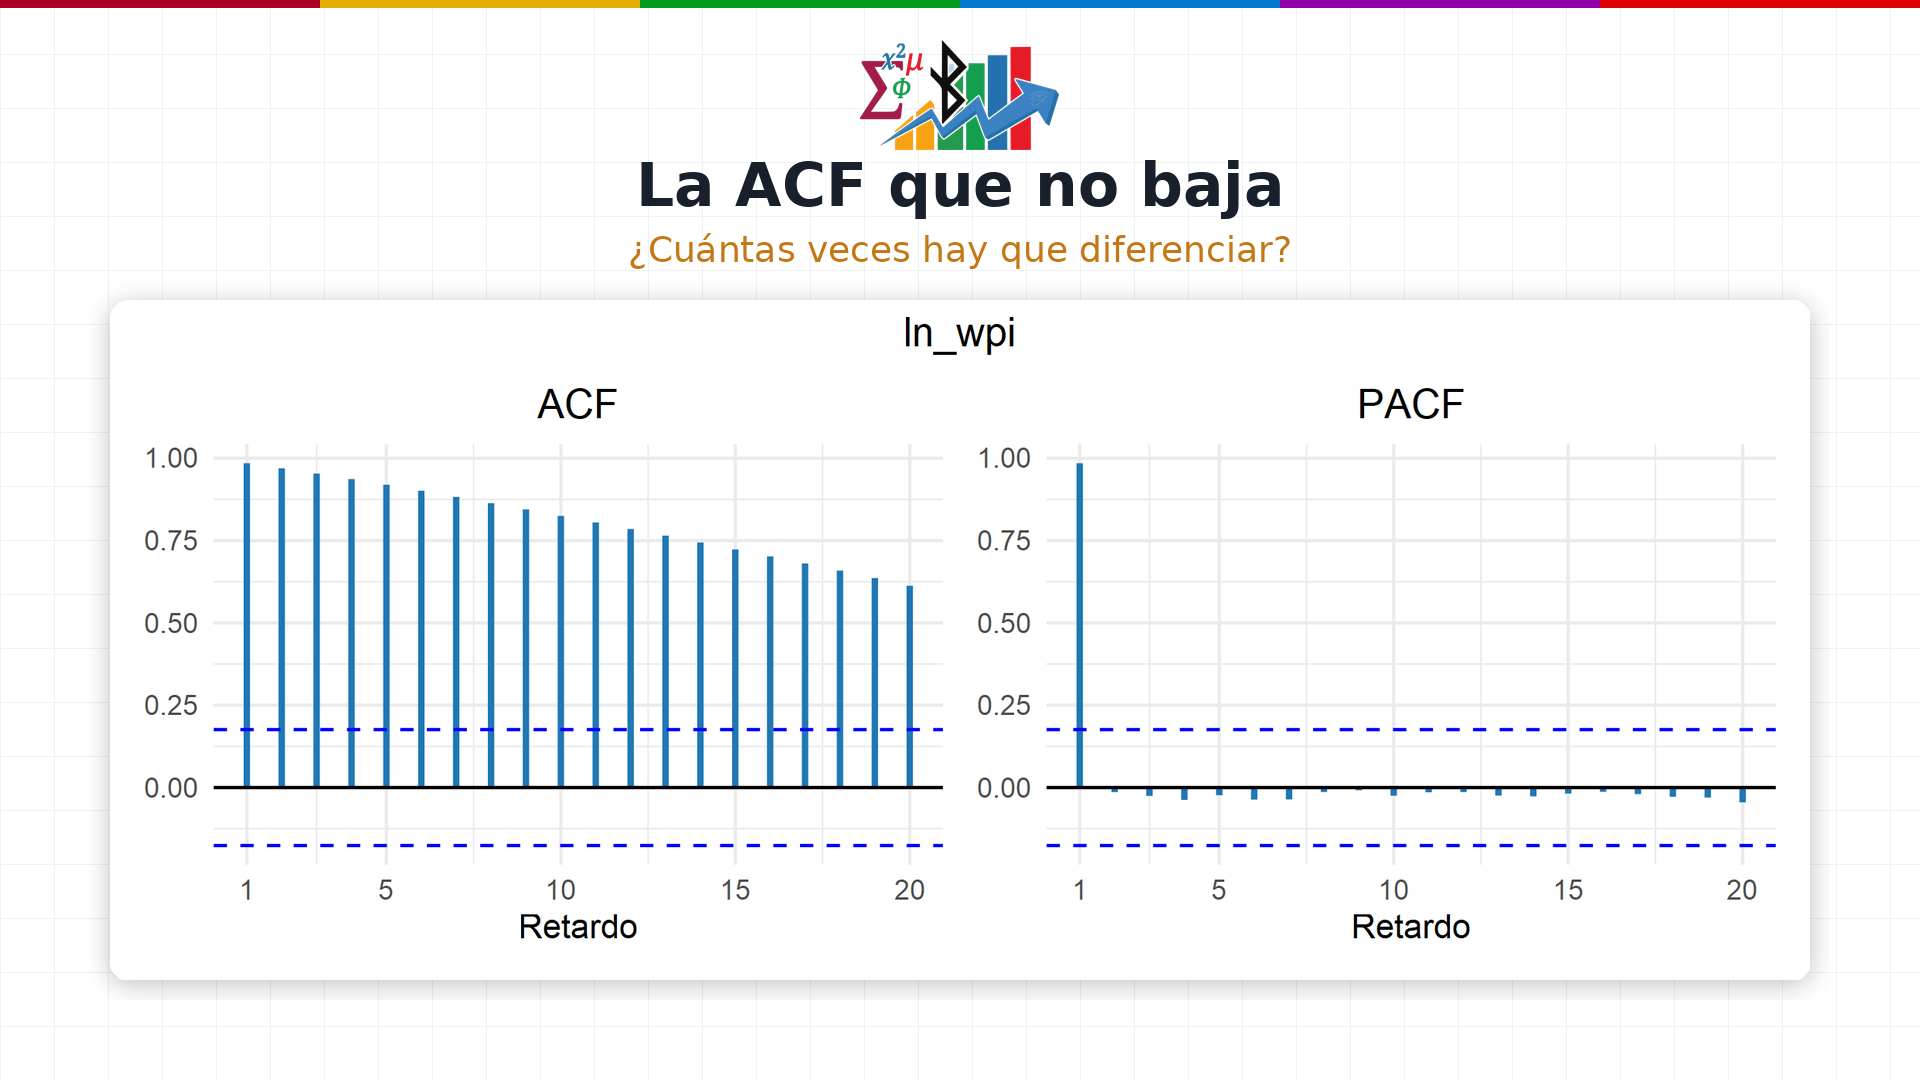
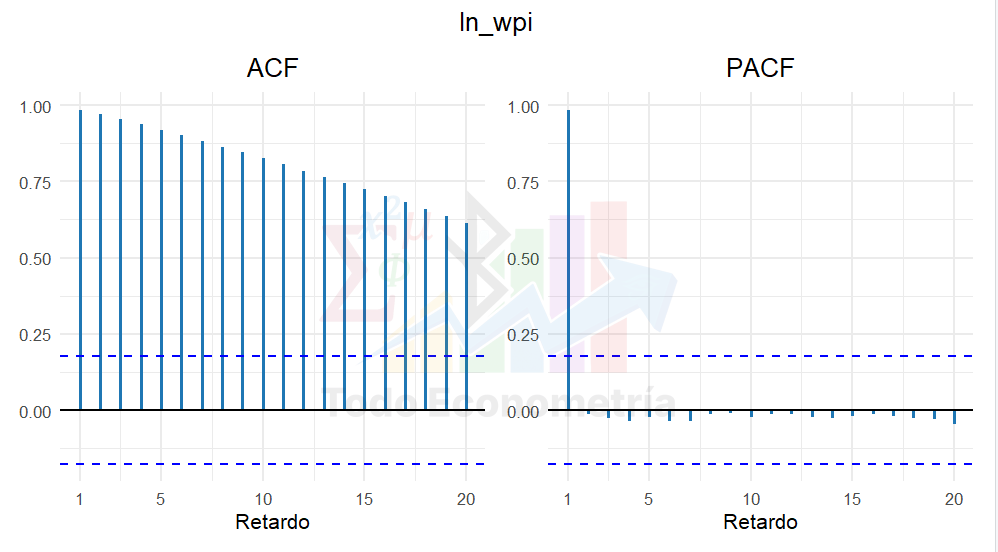
En logaritmos, la ACF empieza en 0.98 y en el retardo 12 todavía va por 0.79. Baja en línea casi recta, sin prisa. Es la firma de una raíz unitaria, la misma del paseo aleatorio.
Confirmarlo con Dickey-Fuller
El contraste de Dickey-Fuller aumentado regresa la diferencia sobre el nivel de ayer, con una tendencia y algunos retardos de la diferencia para limpiar la autocorrelación:
Si , hay raíz unitaria. Ojo con el orden de las hipótesis, que es donde más gente se equivoca: la nula es la raíz unitaria. No rechazar significa que no has podido descartarla.
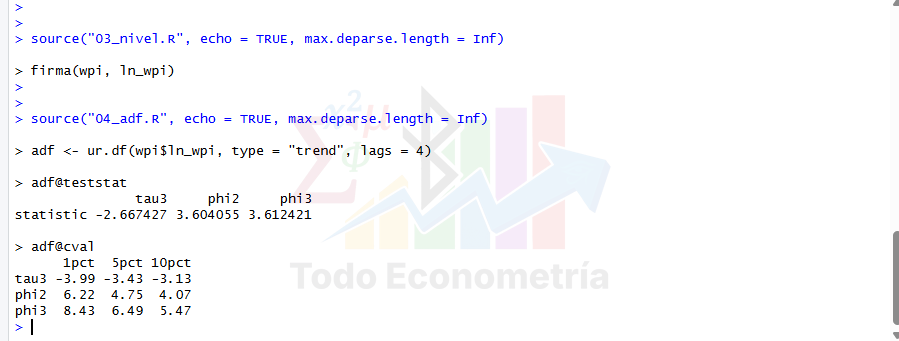
En R, con ur.df, de urca, con tendencia y cuatro retardos:
adf <- ur.df(wpi$ln_wpi, type = "trend", lags = 4)
adf@teststat
adf@cval
El estadístico da −2.67, y los valores críticos son −3.99, −3.43 y −3.13. No llega a ninguno: no se rechaza la raíz unitaria y hay que diferenciar.
Una diferencia: la ACF por fin cae
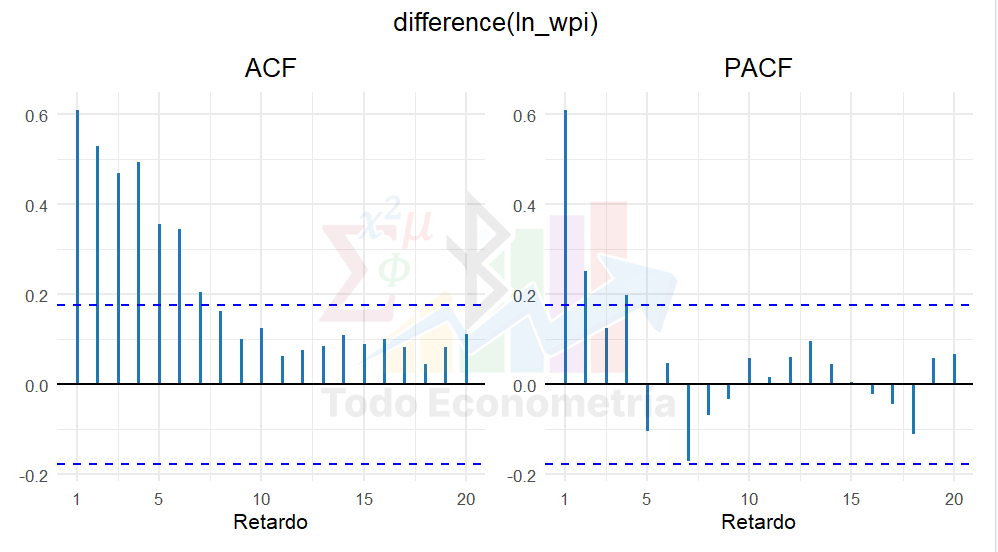
La primera diferencia del logaritmo es, aquí, la inflación trimestral. Su ACF ya sí cae: 0.61, 0.53, 0.47, y en el retardo 12 está en 0.08. Queda dependencia, que modelará un ARMA, pero ya no es la recta de antes.
Sobre la diferencia, con constante:
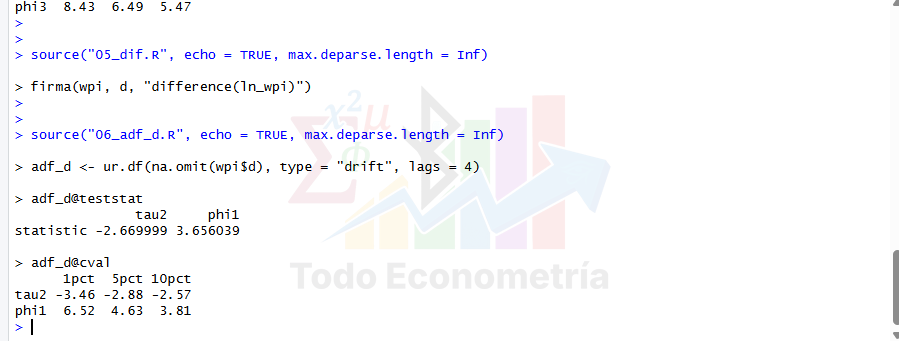
adf_d <- ur.df(na.omit(wpi$d), type = "drift", lags = 4)
adf_d@teststat
adf_d@cval
Da −2.67, frente a −2.88 al 5 % y −2.57 al 10 %. Rechaza al 10 % pero no al 5 %: el caso frontera que los libros no suelen enseñar. La ACF que cae y el contraste apuntan a lo mismo: una diferencia basta.
El precio de diferenciar de más
¿Y si diferenciamos otra vez, por si acaso? Tiene un coste. Si diferencias ruido blanco, sale una media móvil de orden 1 con :
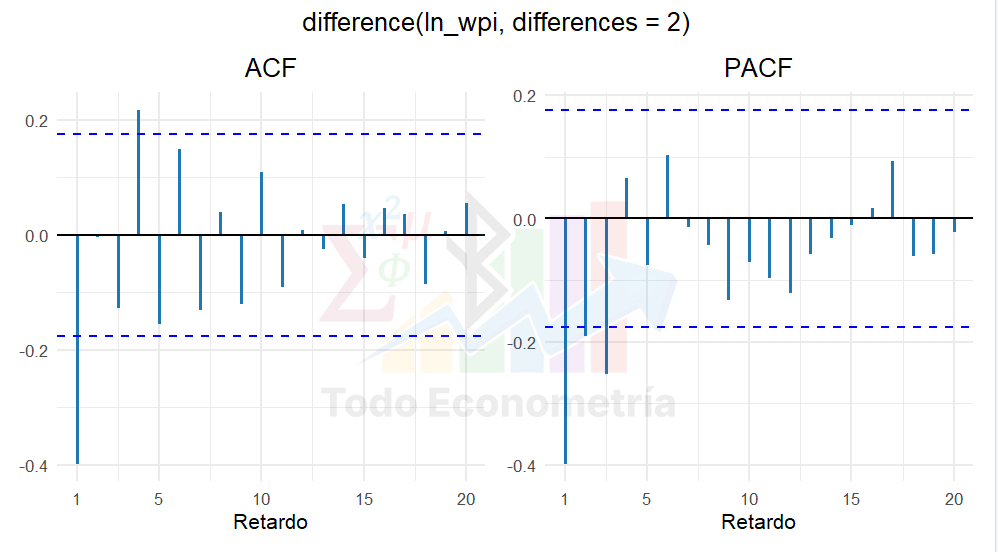
En una simulación de 500 datos sale −0.56. Con los precios, dos diferencias hunden el primer retardo hasta −0.40 y la PACF da varios valores negativos seguidos. Es la huella de diferenciar de más: la segunda diferencia no quita nada y mete una media móvil que no estaba.
Tu turno
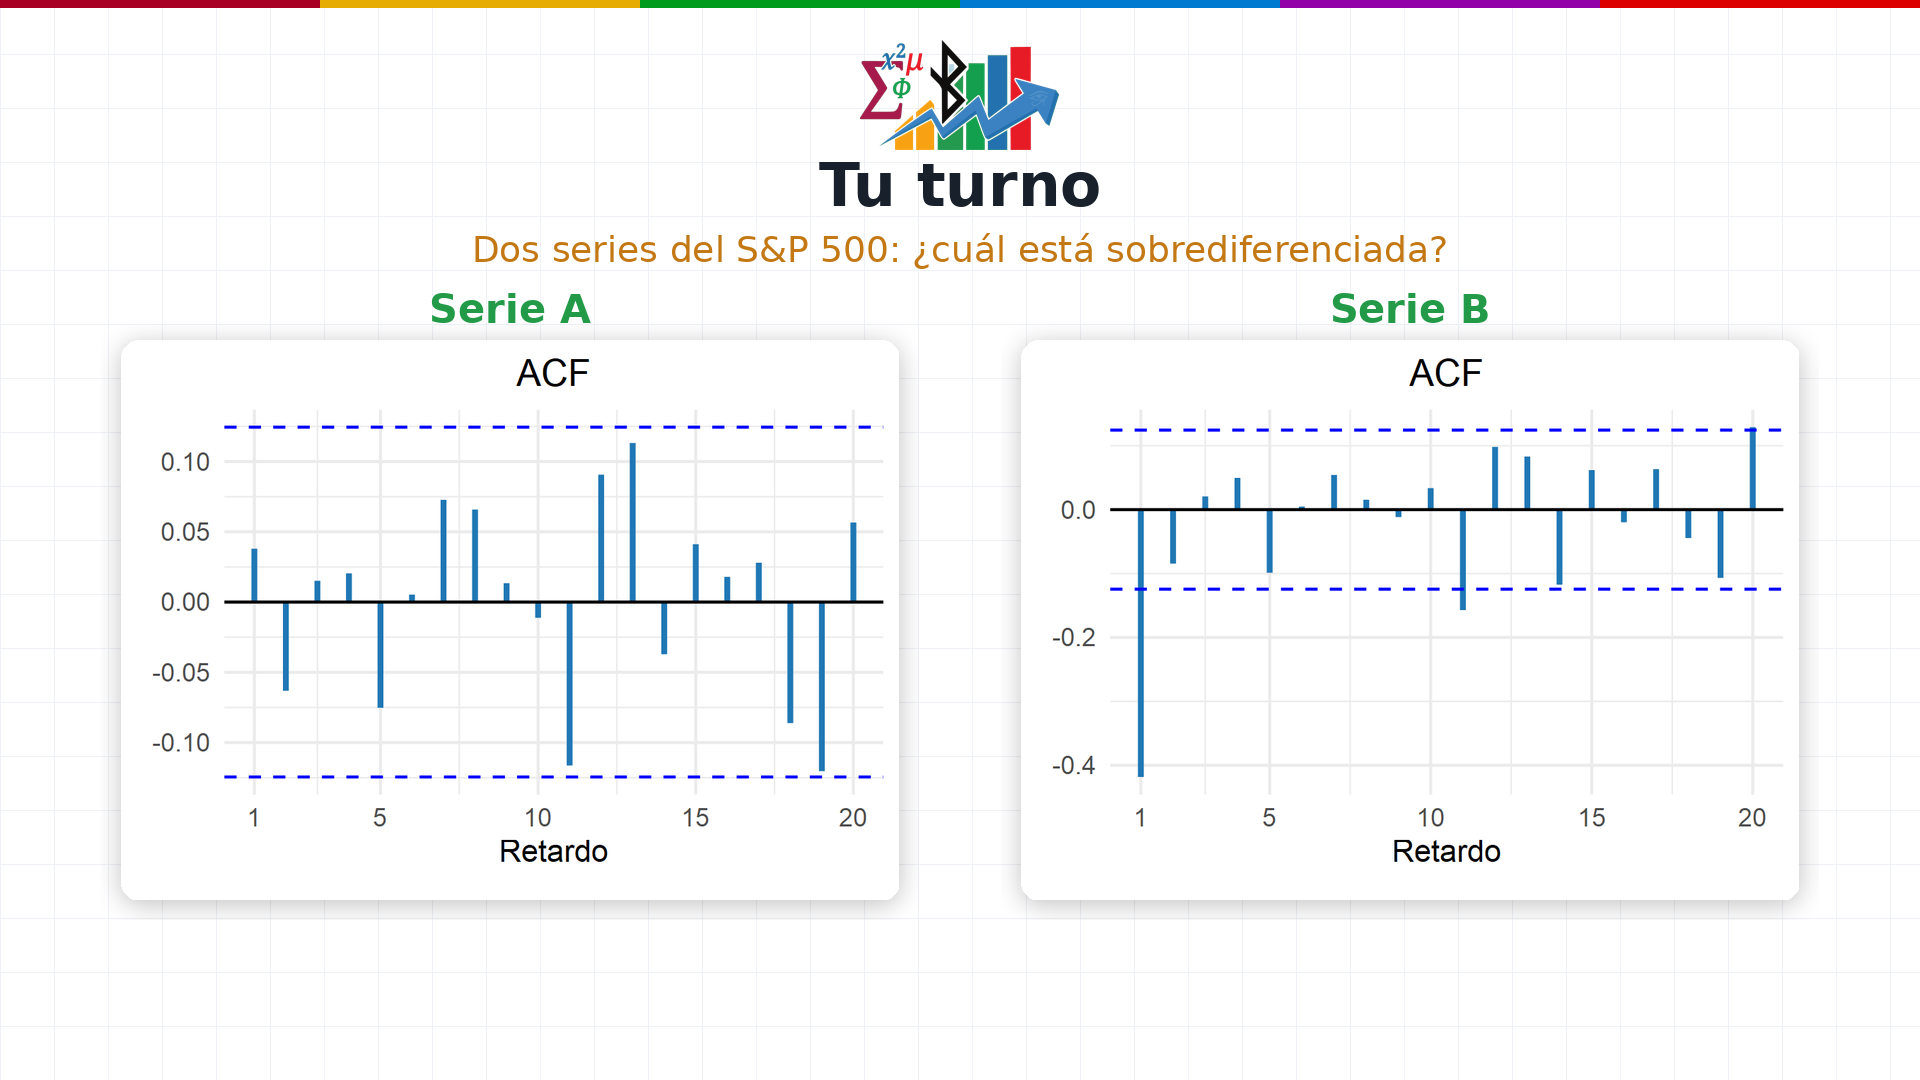
Dos correlogramas del cierre diario del S&P 500 en 2001: uno diferenciado una vez y otro dos veces. ¿Cuál está sobrediferenciado? Decide antes de seguir leyendo.
Solución
La B. La A es la diferencia del cierre: casi ruido blanco, con un primer retardo de 0.04, lo normal en rentabilidades diarias. La B es la segunda diferencia: se hunde hasta −0.42, cerca del −0.5 de la fórmula. Con una bastaba.
Con datos reales
Ninguna de estas señales decide sola. Mira las dos cosas, el correlograma y el contraste, y cuando no coincidan, piensa en el coste: quedarse corto deja una raíz unitaria sin tratar, y pasarse mete una media móvil que no existe.
El tutorial completo, con el código en pantalla: No estacionariedad en R: la ACF que no baja y Dickey-Fuller. Si aún no lo has visto, antes va cómo leer la ACF y la PACF.
Bandas de confianza de la ACF: el retardo que se sale por azar, con simulaciones en R
En un correlograma de 20 retardos de ruido blanco, la probabilidad de ver al menos uno fuera de la banda es del 64 %. Qué significa de verdad que un retardo se salga.
Cómo leer la ACF y la PACF: las firmas de AR, MA y ARMA, con ejemplos en R
Qué se corta y qué decae: la regla para identificar un AR, un MA o un ARMA mirando su ACF y su PACF, demostrada con fórmulas y comprobada con simulaciones en R.
¿Necesitas resolver algo parecido?
Modelización cuantitativa, validación de modelos y data leadership. Trabajo bajo NDA si lo pides.
Háblame de tu proyecto →